4비트가 늘 빠른 건 아니었다: L4 한 장에서 찾은 양자화 교차점
핵심요약
- L4 24GB 한 장에서 Qwen2.5-7B-Instruct를 FP16 vs W8A8(FP8) vs W4A16(Int4/GPTQ)으로 벤치마크했다.
- FP16 decode는 memory bandwidth의 89.7%를 쓰면서 compute utilization은 0.22%에 불과한, 완전한 memory-bound 상태였다.
- concurrency 1→10에서 bandwidth 사용량은 그대로인데 throughput은 7.84배로 늘었다. batching은 가중치 로딩이라는 고정비를 여러 요청이 나눠 지는 방식이다.
- W4A16과 W8A8은 서로 다른 bottleneck을 공격한다. W4A16은 읽어오는 바이트를, W8A8은 compute time을 줄인다.
- 교차점이 실재한다. concurrency 1·10에서는 W4A16이 앞서지만, concurrency 100에서는 W8A8이 역전한다 (TPOT 66.52ms vs 75.05ms).
- 이 역전은 median보다 tail(p99)에서 먼저 나타난다. SLO를 p99 기준으로 잡아야 하는 이유다.
- concurrency 100에서 latency는 W8A8이, throughput은 W4A16이 이긴다. W4A16의 더 큰 KV cache 여유(269K vs 213K tokens)가 더 큰 batch를 만들기 때문이다.
- Marlin kernel이 정상 동작해도 W4A16의 bandwidth 달성률은 67.9%에 그친다. 이론 대비 약 9ms가 dequantization 비용이다.
- 기동 로그의 “Maximum concurrency”는 max-model-len 기준 최악값이다. 실제 ShareGPT 워크로드에서는 PagedAttention 덕분에 표시값보다 9배 넘는 요청을 처리했다.
- 결론: 낮은 부하라면 어디서든 W4A16, 높은 부하에서 latency가 SLO라면 W8A8, 높은 부하에서 throughput이 목표라면 W4A16. 단 이 순위는 L4(Ada) 세대에서 FP8 tensor core와 Marlin이 둘 다 살아있기에 나온 결과다.
들어가며
양자화를 설명하는 자료는 대개 두 갈래로 나눈다.
- W4A16 (가중치 전용): 가중치만 4비트로 줄이고 연산 시점에 다시 16비트로 되돌린다. 역양자화 비용이 붙어서 연산은 별로 안 빨라지는 대신, 읽어오는 데이터량이 크게 준다.
- W8A8 (동시 양자화): 가중치와 활성화를 모두 8비트로 줄인다. 연산 자체가 가속된다.
설명은 정확한데, 여기서 멈추면 실무에서 쓸 수가 없다. 그래서 둘 중 뭘 쓰라는 건가?
답은 있다. 다만 “이게 더 빠르다”가 아니라 “언제 더 빠르다”의 형태다. 그리고 그 “언제”는 부하다. 어딘가에 두 방식이 뒤집히는 교차점이 있어야 한다.
L4 한 장에서 그 교차점을 찾았다. 동시 요청 10과 100 사이에 있었다.
1. 두 기법은 서로 다른 병목을 공격한다
LLM 추론의 두 단계는 병목이 다르다.
- Prefill: 프롬프트 전체를 한 번에 처리. 연산량이 많아 compute-bound
- Decode: 토큰 하나를 만들려고 가중치 전체를 읽어옴. memory-bandwidth-bound
이걸 정량화한 게 산술 강도(arithmetic intensity)다. 메모리에서 1바이트를 읽을 때 연산을 몇 번 하는가. 하드웨어마다 임계 산술 강도가 있는데, 연산 성능을 메모리 대역폭으로 나눈 값이다. 작업의 산술 강도가 이 값보다 낮으면 메모리가 병목이고 높으면 연산이 병목이다.
배칭은 이 값을 끌어올리는 장치다. 같은 가중치를 한 번 읽어 여러 요청에 재사용하니, 배치가 커질수록 바이트당 연산 횟수가 올라간다. 즉 동시 요청 수가 시스템을 memory-bound에서 compute-bound 쪽으로 밀어낸다.
이제 두 양자화 기법을 여기에 대보자.
| 무엇을 줄이나 | 어느 구간에 듣나 | |
|---|---|---|
| W4A16 | 읽어오는 바이트 | memory-bound (낮은 부하) |
| W8A8 | 필요한 연산 시간 | compute-bound (높은 부하) |
서로 다른 병목을 공격한다. 그러니 부하를 올리다 보면 어느 지점에서 우열이 뒤집혀야 한다. 그게 이 글에서 찾으려는 것이다.
2. 측정 전 예측
숫자를 보기 전에 예측을 적어뒀다.
- concurrency 1에서 FP16 디코드는 심하게 memory-bound일 것이다. 연산 유닛은 거의 놀 것이다.
- concurrency를 올리면 처리량은 크게 늘지만 TPOT은 조금만 나빠질 것이다.
- 낮은 부하에서는 W4A16이, 높은 부하에서는 W8A8이 유리할 것이다. 어딘가에 교차점이 있다.
- FP16은 가중치가 14.29 GiB라 KV 캐시 여유가 적다. 높은 부하에서 연산이 아니라 메모리 때문에 먼저 무너질 것이다.
1~3은 맞았고 4번은 틀렸다. 그리고 4번이 왜 틀렸는지가 가장 배울 게 많았다.
3. 실험 환경
| 항목 | 값 |
|---|---|
| GPU | NVIDIA L4 24GB (Ada, sm_89), 드라이버 580.82.07, CUDA 13.0 |
| 메모리 대역폭 | 300 GB/s |
| FP16 텐서코어 | 121 TFLOPS (dense) |
| 임계 산술 강도 | 403 FLOP/byte |
| vLLM | 0.27.1 (V1 엔진, --enforce-eager) |
| 어텐션 백엔드 | FlashAttention 2 (3종 모두 동일) |
| 데이터셋 | ShareGPT V3 (요청당 평균 입력 218 / 출력 220 토큰) |
| max-model-len | 4096 |
| concurrency | 1 / 10 / 100 |
비교 대상 3종은 모두 Qwen2.5-7B-Instruct 계열이다.
| 모델 | 커널 | 활성화 dtype | |
|---|---|---|---|
| FP16 | Qwen/Qwen2.5-7B-Instruct |
— | float16 |
| W8A8 | RedHatAI/Qwen2.5-7B-Instruct-FP8-dynamic |
CutlassFP8ScaledMMLinearKernel |
bfloat16 |
| W4A16 | Qwen/Qwen2.5-7B-Instruct-GPTQ-Int4 |
MarlinLinearKernel |
float16 |
두 양자화 모두 네이티브 고속 커널이 선택됐다. L4가 Ada 세대라 FP8은 Cutlass 텐서코어 경로를, GPTQ는 Marlin을 쓴다. 폴백 없이 각자 최선의 조건에서 비교한 셈이다. Ampere 이전 GPU였다면 Marlin이 안 잡히고 FP8은 하드웨어 가속 자체가 없어서 결과가 완전히 달라졌을 것이다.
한 가지 유의점. FP8 체크포인트는 bfloat16, 나머지 둘은 float16으로 떴다. 활성화 dtype이 달라 완전한 통제 실험은 아니다.
환경 함정 4종
O’Reilly Hands-On LLM Serving and Optimization 6장 실습 노트북(orca3/llm-model-inference)을 Colab에서 돌렸는데, 지금은 그대로 실행하면 한 줄도 안 돌아간다. 같은 실습을 하려는 사람이 반드시 밟게 되는 지뢰라 먼저 적어둔다.
① Python 3.13에서 vLLM 0.8.5 설치 불가
ERROR: Could not find a version that satisfies the requirement vllm==0.8.5.post1
ERROR: Ignored the following versions that require a different python version:
       0.10.0 Requires-Python <3.13,>=3.9
Colab 기본 Python이 3.13으로 올라갔는데, 노트북이 핀 고정한 0.8.5는 물론 0.10.x까지도 <3.13 제약이 있다. 버전 핀을 빼고 최신(0.27.1)을 받아야 한다.
② torchaudio CUDA 버전 충돌
RuntimeError: Detected that PyTorch and TorchAudio were compiled with
different CUDA versions. PyTorch has CUDA version 13.0 whereas TorchAudio
has CUDA version 12.8.
최신 vLLM이 torch 2.13(CUDA 13.0)을 끌고 오는데 Colab에 미리 깔린 torchaudio는 CUDA 12.8이다. transformers가 torchaudio를 import하는 경로를 타서 vLLM 자체가 안 뜬다.
③ torchvision을 지웠더니 엔진 초기화 실패
②를 해결하려고 torchaudio와 torchvision을 지웠더니 이번엔 이렇게 죽었다.
File "vllm/model_executor/warmup/kernel_warmup.py", line 100, in kernel_warmup
  from vllm.model_executor.warmup.minimax_m3_msa_warmup import (
...
ModuleNotFoundError: No module named 'torchvision'
vLLM 0.27.1의 kernel_warmup은 쓰지도 않는 MiniMax-M3 모듈을 무조건 import하고, 그게 torchvision을 요구한다. 지우는 게 아니라 CUDA 버전을 맞추는 게 정답이었다.
pip install torchvision torchaudio --index-url https://download.pytorch.org/whl/cu130
④ 벤치마크 스크립트 경로 변경
노트북은 vllm/benchmarks/benchmark_serving.py를 clone해서 쓰지만 최신 버전엔 없다. vllm bench serve CLI로 옮겨갔고 인자는 거의 그대로다. 또 이 버전부터 벤치마크가 기본으로 greedy를 쓰지 않으니 재현성을 위해 --temperature 0을 명시하는 게 좋다.
4. 기준선: 디코드는 대역폭에 붙어 있었다
FP16, concurrency 1.
| 지표 | 값 |
|---|---|
| 출력 처리량 | 17.46 tok/s |
| median TTFT | 95.10 ms |
| median TPOT | 57.03 ms |
| TPOT 표준편차 | 0.11 ms |
TPOT 57ms를 어떻게 봐야 할까. 이론 하한을 계산해보자.
토큰 하나를 만들려면 가중치 전체를 HBM에서 읽어야 한다. 로그에 찍힌 실제 로딩 크기가 14.29 GiB, 바이트로는 15.34 GB. L4 대역폭은 300 GB/s.
이론 하한 = 15.34 GB ÷ 300 GB/s = 51.1 ms
실측      = 57.03 ms
→ 대역폭 달성률 89.7%
메모리 대역폭의 90%를 쓰고 있다. 이보다 빨라질 여지가 사실상 없다.
반대편은 어떨까. 디코드 한 스텝의 연산량은 대략 2 × 파라미터 수니까 토큰당 15.2 GFLOP. 초당 17.46토큰이면 0.27 TFLOPS.
L4 FP16 성능 : 121 TFLOPS
실제 사용    : 0.27 TFLOPS
→ 연산 이용률 0.22%
GPU 연산 유닛의 99.78%가 놀고 있다. 산술 강도로 보면 0.99 FLOP/byte인데 L4 임계점이 403이니 406배 아래다. memory-bound가 은유가 아니라 문자 그대로다.
TPOT 표준편차 0.11ms가 이 해석을 굳혀준다. 편차가 거의 0인 건 경합이나 스케줄링 변동이 아니라 물리 한계에 붙어 있어서 매번 같은 시간이 걸린다는 뜻이다.
예측 1번 확인.
배칭은 고정비를 나눠 지는 일
concurrency를 올려봤다.
| FP16 | conc 1 | conc 10 | conc 100 |
|---|---|---|---|
| 출력 처리량 | 17.46 tok/s | 136.95 tok/s | 642.29 tok/s |
| median TPOT | 57.03 ms | 60.68 ms | 97.72 ms |
| 평균 배치 | 1.0 | 8.3 | 62.8 |
| 실효 대역폭 | 269 GB/s | 253 GB/s | 157 GB/s |
| 연산 이용률 | 0.22% | 1.72% | 8.09% |
conc 1과 10을 보라. 대역폭 사용량은 269 → 253 GB/s로 거의 그대로인데 토큰은 7.84배가 됐다. TPOT은 겨우 6.4% 나빠졌을 뿐이다.
메모리 버스를 오가는 가중치 15.34GB는 배치가 1이든 10이든 똑같다. 고정비다. 배칭은 그 고정비를 여러 요청이 나눠 지게 만든다. 배칭이 왜 선택이 아니라 필수인지가 이 두 줄에 다 있다.
예측 2번 확인.
5. 3종 비교: 교차점을 찾았다
이제 본론이다. 세 정밀도를 같은 조건으로 돌렸다.
기동 시점: 가중치가 준 만큼 KV 캐시가 는다
| 가중치 | KV 캐시 여유 | KV 토큰 | 엔진 초기화 | |
|---|---|---|---|---|
| FP16 | 14.29 GiB | 5.46 GiB | 102,288 | 110.88 s |
| W8A8 (FP8) | 8.18 GiB | 11.4 GiB | 213,424 | 5.58 s |
| W4A16 (Int4) | 5.27 GiB | 14.41 GiB | 269,824 | 7.46 s |
가중치가 줄어든 만큼이 정확히 KV 캐시로 넘어간다. 양자화는 속도만이 아니라 수용량을 바꾼다. 뒤에서 보겠지만 이 차이가 높은 부하에서 예상 못 한 방식으로 결과에 개입한다.
median TPOT: 뒤집히는 지점
| median TPOT | conc 1 | conc 10 | conc 100 |
|---|---|---|---|
| FP16 | 57.03 ms | 60.68 ms | 97.72 ms |
| W8A8 (FP8) | 34.91 ms | 37.27 ms | 66.52 ms |
| W4A16 (Int4) | 27.79 ms | 30.04 ms | 75.05 ms |
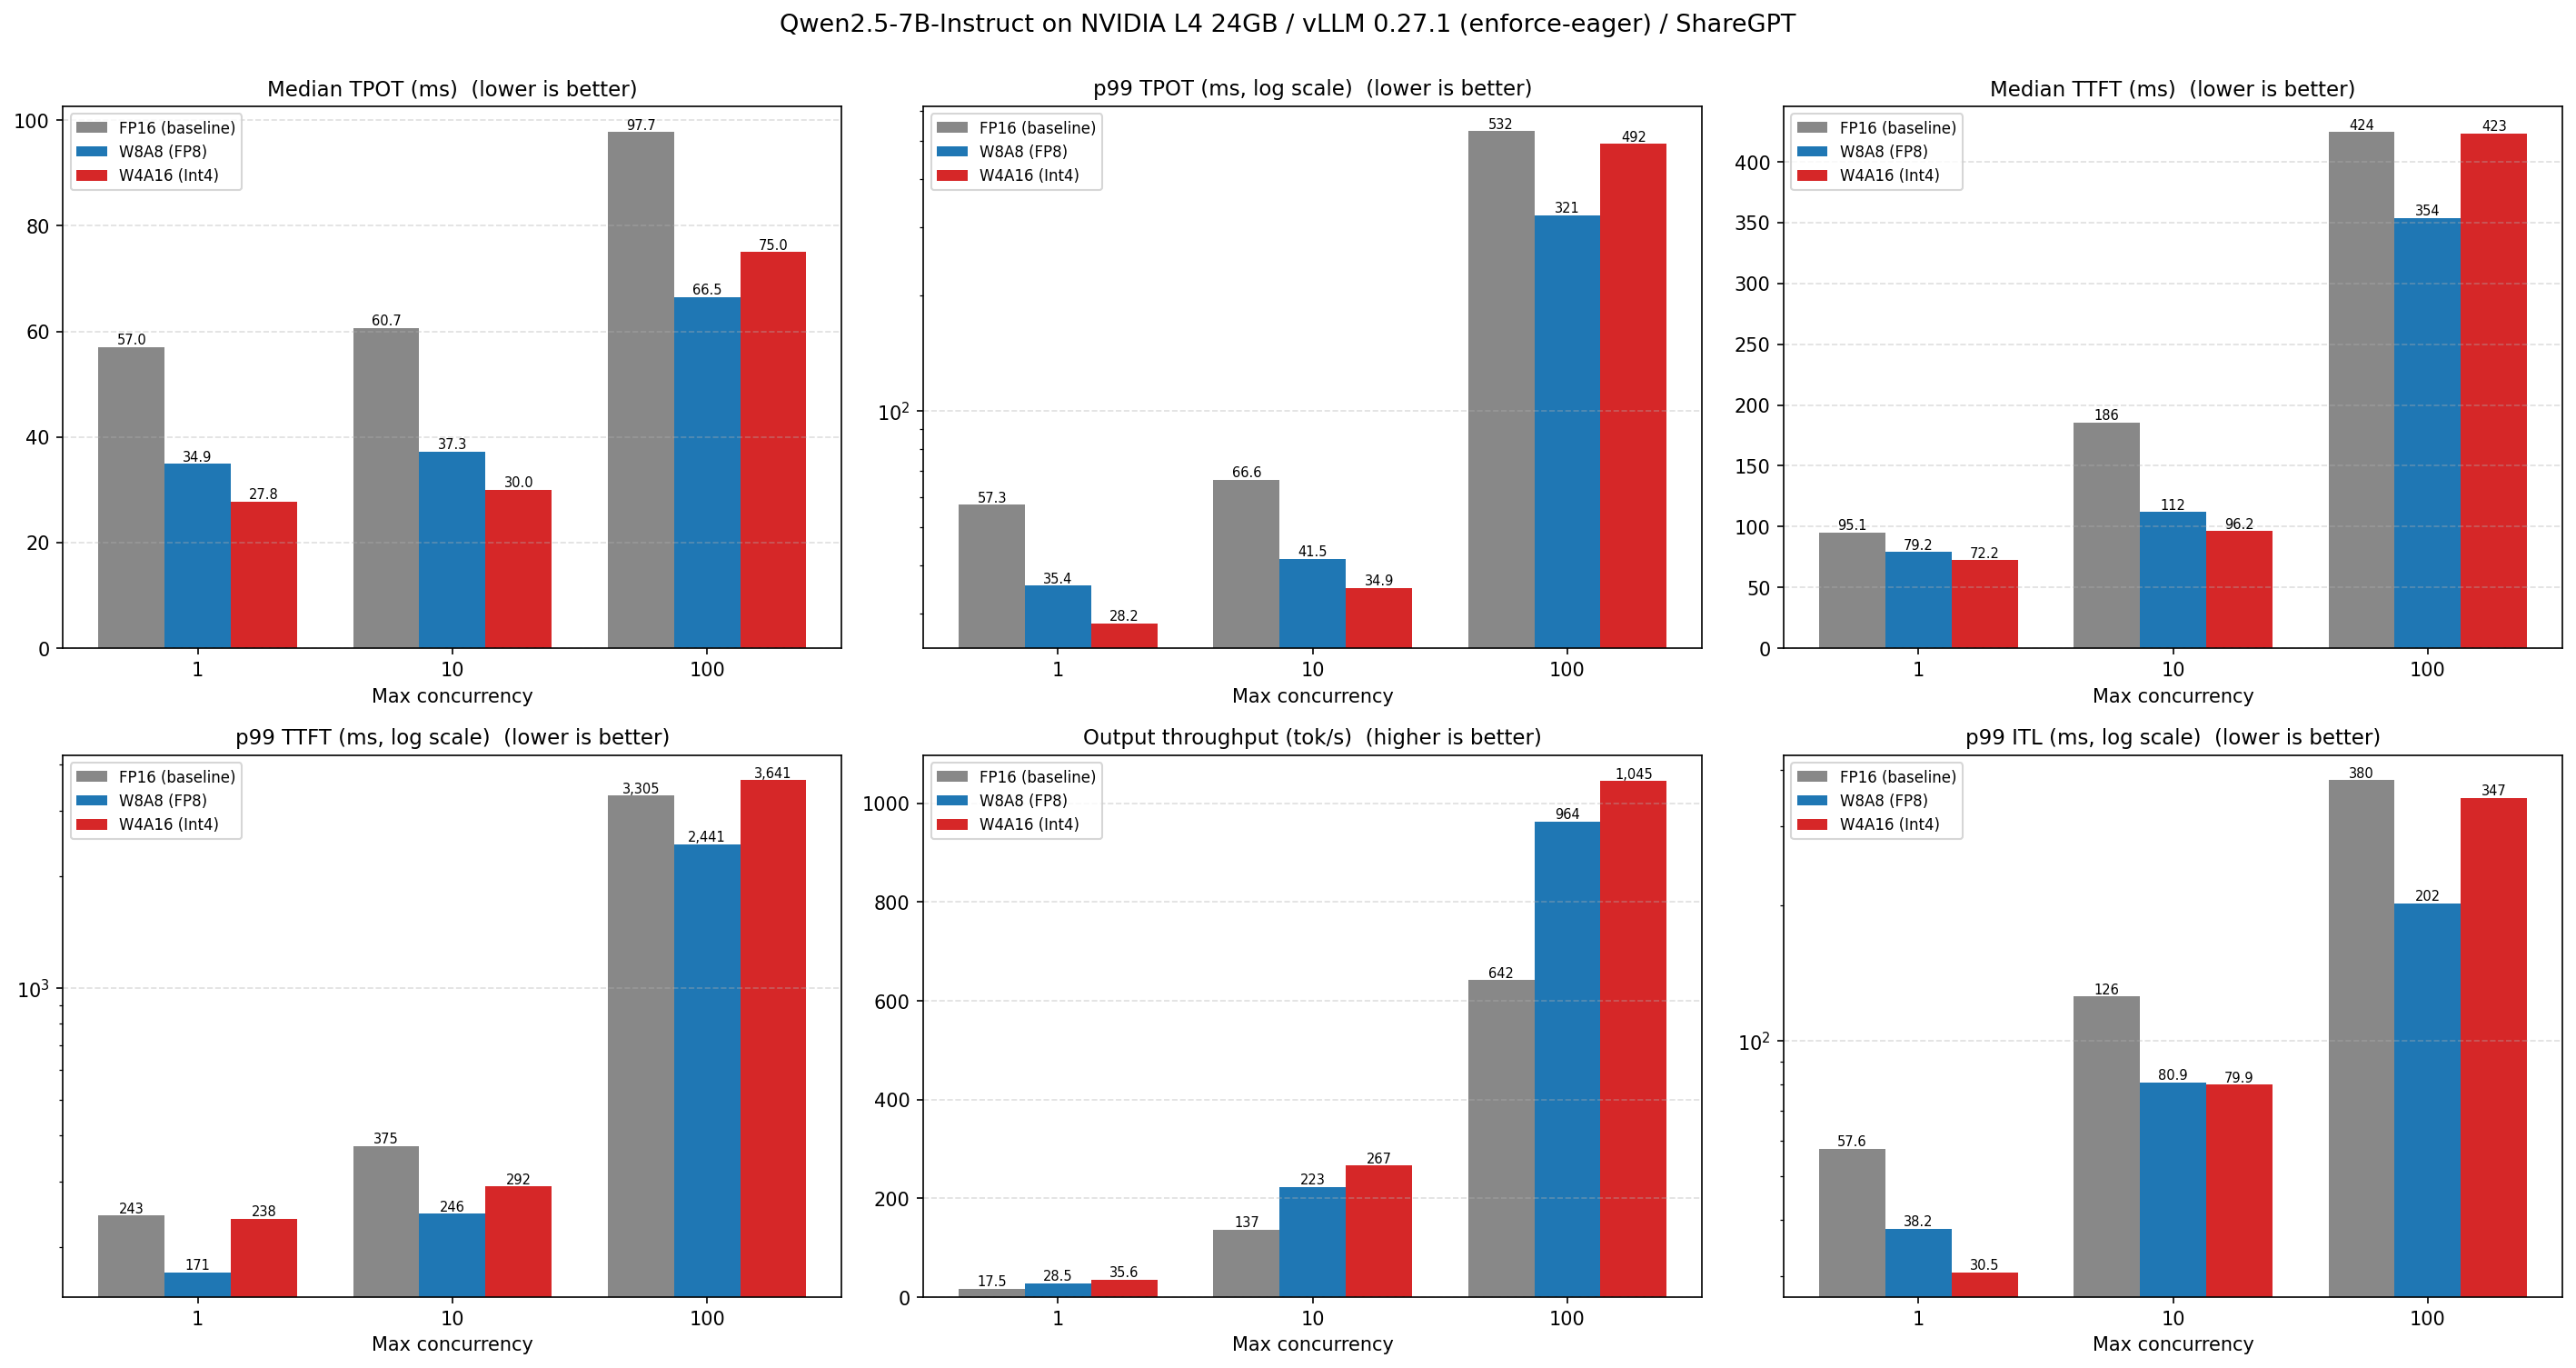
교차했다. concurrency 1과 10에서는 W4A16이 가장 빠르지만, concurrency 100에서 W8A8이 W4A16을 앞선다. 왼쪽 위 패널에서 빨간 막대가 두 지점까지 가장 낮다가 마지막에만 파란 막대 위로 올라서는 게 그것이다.
FP16 대비 이득으로 보면 추세가 더 선명하다.
| FP16 대비 TPOT 이득 | conc 1 | conc 10 | conc 100 |
|---|---|---|---|
| W8A8 | 1.63배 | 1.63배 | 1.47배 |
| W4A16 | 2.05배 | 2.02배 | 1.30배 |
W4A16의 이득이 2.05배에서 1.30배로 무너지는 동안 W8A8은 1.63 → 1.47로 거의 버틴다. 예측 3번 확인.
교차는 꼬리에서 먼저 시작된다
흥미로운 건 이 역전이 중앙값보다 꼬리에서 먼저 나타났다는 점이다. concurrency 10의 p99 ITL을 보면 W8A8 80.9ms, W4A16 79.9ms로 이미 사실상 동률이다. 같은 지점의 median TPOT은 30.04 대 37.27로 W4A16이 여전히 24% 앞서는데도 그렇다.
꼬리 지연은 배치가 커질 때 가장 먼저 반응하는 지표다. 중앙값은 대부분의 요청이 순조롭게 흐르는 한 잘 버티지만, p99는 스케줄러가 밀리기 시작하는 순간을 바로 반영한다. 교차점을 관찰하려면 중앙값보다 p99를 봐야 한다는 뜻이고, 이건 SLO를 p99로 잡는 실무 관행과도 맞아떨어진다.
TTFT에서는 반대 방향의 조기 신호도 보인다. concurrency 1의 p99 TTFT는 FP16 243ms, W4A16 238ms로 거의 같다. median TTFT에서는 95.10 대 72.24로 W4A16이 24% 앞서는데, 꼬리에서는 이득이 사라진다. 긴 프롬프트일수록 prefill의 연산 비중이 커지고 역양자화 오버헤드가 그만큼 더 물리기 때문으로 보인다.
왜 그런가: 산술 강도가 설명한다
| 산술 강도 (FLOP/byte) | conc 1 | conc 10 | conc 100 |
|---|---|---|---|
| FP16 | 1.0 | 8.3 | 62.3 |
| W8A8 | 1.7 | 14.4 | 111.2 |
| W4A16 | 2.7 | 21.6 | 211.2 |
| 대역폭 달성률 | conc 1 | conc 10 | conc 100 |
|---|---|---|---|
| FP16 | 89.7% | 84.3% | 52.3% |
| W8A8 | 83.9% | 78.6% | 44.0% |
| W4A16 | 67.9% | 62.8% | 25.1% |
W4A16이 가장 먼저 memory-bound를 탈출한다. 바이트를 4분의 1로 줄였으니 당연하다. concurrency 100에서 산술 강도가 211까지 올라 L4 임계점 403의 절반에 도달했고, 대역폭 달성률은 25%로 떨어졌다.
그런데 memory-bound를 벗어난다는 건 W4A16의 무기가 안 통하는 영역에 들어선다는 뜻이기도 하다. 바이트를 아무리 더 줄여도 이제 병목이 거기가 아니다. 반면 연산을 가속하는 W8A8은 이 영역에서 제 값을 한다.
이게 교차점의 정체다.
역양자화 비용을 숫자로
이론 하한과 실측을 비교하면 흥미로운 게 나온다.
| conc 1 | 가중치 | 이론 TPOT | 실측 TPOT | 달성률 |
|---|---|---|---|---|
| FP16 | 15.34 GB | 51.1 ms | 57.03 ms | 89.7% |
| W8A8 | 8.78 GB | 29.3 ms | 34.91 ms | 83.9% |
| W4A16 | 5.66 GB | 18.9 ms | 27.79 ms | 67.9% |
Marlin 커널이 정상 선택됐는데도 W4A16의 달성률만 68%로 뚝 떨어진다. 이론보다 약 9ms 느리다. int4를 fp16으로 풀어서 GEMM에 넣어야 하기 때문이다.
“W4A16은 역양자화가 필요해 연산 속도 개선은 적다”는 설명을, 9ms라는 숫자로 측정한 셈이다. 정성적 서술이 정량적 값으로 바뀌는 순간이 이 실험에서 가장 재미있었다.
그런데 처리량은 W4A16이 이긴다
concurrency 100의 전체 그림은 단순하지 않다.
| conc 100 | FP16 | W8A8 (FP8) | W4A16 (Int4) | 승자 |
|---|---|---|---|---|
| median TPOT | 97.72 ms | 66.52 ms | 75.05 ms | W8A8 |
| p99 TPOT | 531.82 ms | 321.48 ms | 492.34 ms | W8A8 |
| median TTFT | 424.41 ms | 353.78 ms | 423.26 ms | W8A8 |
| p99 TTFT | 3,305 ms | 2,441 ms | 3,641 ms | W8A8 |
| 출력 처리량 | 642.29 tok/s | 963.60 tok/s | 1,044.93 tok/s | W4A16 |
| 평균 배치 | 62.8 | 64.1 | 78.4 |
지연시간 지표는 전부 W8A8이 이기는데 처리량만 W4A16이 이긴다. 처음엔 모순처럼 보였는데, 평균 배치를 보면 설명이 된다.
W4A16은 KV 캐시가 269,824토큰으로 W8A8의 213,424토큰보다 26% 크다. 그래서 스케줄러가 더 많은 시퀀스를 동시에 받아들인다(78.4 vs 64.1). 배치가 크면 처리량은 오르고 요청당 지연시간은 나빠진다. 5장 앞부분에서 본 “가중치가 준 만큼 KV 캐시가 는다”가 여기서 이렇게 돌아온다.
즉 W4A16은 더 큰 배치로 더 많이 처리하되 개별 요청은 더 오래 기다리게 만들고, W8A8은 적당한 배치로 빠르게 응답한다. 같은 GPU에서 다른 운영 지점에 서 있는 것이다.
그래서 실무적 결론은 이렇게 갈린다.
- 대화형 서비스(TTFT/ITL이 SLO) → 높은 부하에서는 W8A8
- 배치 처리(총 처리량이 목표) → W4A16
- 낮은 부하 어디서든 → W4A16이 압도적
중앙값은 버티고 꼬리가 무너진다
셋 다 공통으로 나타난 현상 하나. FP16 기준으로 보면 이렇다.
median TPOT :  57.03 → 97.72 ms   (+71%)
p99 TPOT    :  57.25 → 531.82 ms  (9.3배)
p99 TTFT    : 243.28 → 3,305 ms   (13.6배)
중앙값은 71% 나빠지는 데 그쳤는데 p99는 9배가 됐다. 평균만 보면 “조금 느려졌네” 수준이지만 실제로는 100명 중 1명이 첫 글자를 3.3초 기다린다.
여기서 goodput이 왜 필요한지가 분명해진다. SLO가 “TTFT 1초 이내”라면 conc 100의 처리량은 장부상 숫자일 뿐이다. 그리고 이 기준으로 보면 W8A8의 우위가 더 커진다. p99 TTFT가 2.44초 대 3.64초니까.
6. 예측 4번은 왜 틀렸나
서버 기동 로그에 이런 줄이 찍힌다.
Available KV cache memory: 5.46 GiB
GPU KV cache size: 102,288 tokens
Maximum concurrency for 4,096 tokens per request: 24.97x
“최대 동시성 24.97” 을 보고 나는 concurrency 100을 걸면 25개만 돌고 나머지는 큐에서 대기하며 preemption이 터질 거라 예측했다.
틀렸다. 200개 요청이 68.65초에 전부 완주했고 실패 0건, preemption도 관측되지 않았다. 평균 배치는 62.8까지 올라갔다.
이유는 단순했다. 저 숫자는 “모든 요청이 max-model-len인 4,096 토큰을 다 쓴다면” 이라는 최악 가정에서 나온 값이다. 실제 ShareGPT 요청은 이랬다.
요청당 입력 218 + 출력 220 = 약 438 토큰
102,288 ÷ 438 ≈ 233개
실제 수용량은 233개, 표시된 값의 9배가 넘는다. KV 캐시는 예약이 아니라 실제 쓴 만큼만 잡히기 때문이다. PagedAttention이 하는 일이 정확히 이거다. 요청마다 최대 길이를 미리 예약하지 않고 필요한 블록만 동적으로 할당한다.
교훈은 이거다. 기동 로그의 “Maximum concurrency”는 용량 상한이 아니라 최악 가정 하한이다. 용량 산정을 하려면 자기 워크로드의 평균 시퀀스 길이를 먼저 재야 한다. 그 숫자 없이 로그만 보고 계획을 세우면 9배를 틀린다.
덤: CUDA 그래프는 KV 캐시를 먹는다
처음 기동했을 때 워밍업 단계에서 엔진이 죽어 --enforce-eager로 다시 올렸는데, 두 실행의 로그를 비교하니 이랬다.
| FP16 | 기본 (CUDA 그래프 ON) | --enforce-eager |
|---|---|---|
| KV 캐시 여유 | 3.7 GiB | 5.46 GiB |
| KV 캐시 토큰 | 69,328 | 102,288 |
| 표시 최대 동시성 | 16.93x | 24.97x |
같은 GPU, 같은 모델, 같은 설정인데 플래그 하나로 KV 캐시가 47% 늘었다. CUDA 그래프는 지연시간을 줄여주는 대신 캡처용 메모리를 상주시키고, 그만큼이 KV 캐시 예산에서 빠진다. 지연시간과 수용량을 맞바꾸는 스위치가 하나 더 있는 셈이다.
덤 2: 콜드 스타트
FP16 1회차: Model loading took 14.29 GiB and 153.87 seconds
FP16 2회차: Model loading took 14.29 GiB and   8.86 seconds
init engine (profile, create kv cache, warmup model) took 110.88 s
첫 기동은 다운로드 포함 154초, 캐시가 있으면 8.9초. 여기에 프로파일링과 워밍업이 111초 더 붙는다.
오토스케일링을 생각하면 그냥 넘길 숫자가 아니다. 트래픽이 튀어서 인스턴스를 하나 더 띄우려면 2분 가까이 아무것도 못 한다. 흥미롭게도 양자화 모델은 엔진 초기화가 5~7초로 훨씬 짧았다. 모델이 작으면 프로파일링과 워밍업도 그만큼 빨라진다.
7. 정리
예측 대조표.
| 예측 | 결과 | |
|---|---|---|
| 1 | FP16 디코드는 심하게 memory-bound | ✅ 대역폭 89.7%, 연산 0.22% |
| 2 | 배칭하면 처리량↑ TPOT는 조금만↓ | ✅ 7.84배 vs +6.4% |
| 3 | 낮은 부하 W4A16, 높은 부하 W8A8 | ✅ conc 10~100 사이에서 교차 |
| 4 | KV 캐시 부족으로 먼저 무너짐 | ❌ 실제 수용량은 표시값의 9배 |
원래 질문 — “W4A16과 W8A8 중 뭘 쓰나” — 에 대한 L4에서의 답은 이렇다.
낮은 부하라면 W4A16. concurrency 1에서 TPOT이 FP16의 절반이고 W8A8보다도 20% 빠르다. 개인용, 사내 도구, 요청이 드문 서비스라면 고민할 것도 없다.
높은 부하이고 응답 지연이 SLO라면 W8A8. concurrency 100에서 median TPOT, p99 TPOT, TTFT 모두 W8A8이 이긴다. 특히 p99 TTFT가 2.44초 대 3.64초로 1.2초 차이가 난다.
높은 부하이고 총 처리량이 목표라면 W4A16. 초당 1,045토큰으로 가장 많이 뽑는다. 개별 요청은 느리지만 GPU를 가장 알뜰하게 쓴다.
그리고 이 결론에는 큰 단서가 붙는다. L4가 Ada 세대라 FP8 텐서코어와 Marlin 커널이 둘 다 살아 있었기 때문에 나온 결과다. Ampere 이전 GPU에서는 FP8 하드웨어 가속이 없고 Marlin도 안 잡히니 순위가 통째로 뒤집힐 수 있다. 양자화 포맷은 하드웨어 세대와 묶여 있고, 벤치마크 결과는 그 조합에만 유효하다.
다음 편에서는 세 모델의 품질을 재보려 한다. 오늘은 속도만 봤는데, 압축률·속도·품질 세 축이 모여야 실제 선택 기준이 된다.
요약
- L4에서 Qwen2.5-7B FP16의 디코드는 메모리 대역폭 89.7%를 쓰면서 연산은 0.22%만 쓴다. 산술 강도 0.99 대 임계점 403.
- TPOT 57.03ms는 이론 하한 51.1ms의 89.7%. 양자화 없이는 더 빨라질 여지가 없다.
- concurrency 1 → 10에서 대역폭 사용량은 그대로인데 처리량은 7.84배. 가중치 읽기는 고정비고 배칭이 그걸 나눠 진다.
- 교차점은 실재한다. W4A16은 conc 1·10에서 1등이지만 conc 100에서 W8A8에 역전당한다 (75.05 vs 66.52ms).
- FP16 대비 W4A16의 TPOT 이득은 2.05배 → 1.30배로 무너지고, W8A8은 1.63 → 1.47로 버틴다.
- W4A16은 conc 100에서 산술 강도 211로 가장 먼저 memory-bound를 탈출한다. 그게 강점이 사라지는 이유다.
- Marlin이 살아 있는데도 W4A16의 대역폭 달성률은 67.9%. 이론 대비 약 9ms가 역양자화 비용이다.
- conc 100에서 지연시간은 W8A8이, 처리량은 W4A16이 이긴다. W4A16의 큰 KV 캐시가 더 큰 배치(78.4 vs 64.1)를 만들기 때문이다.
- 교차는 꼬리에서 먼저 시작된다. conc 10의 p99 ITL은 80.9 대 79.9로 이미 동률인데 median TPOT은 아직 W4A16이 24% 앞선다.
- 부하가 오르면 중앙값은 버티고 꼬리가 무너진다. median TPOT +71%인데 p99는 9.3배.
- 기동 로그의 “Maximum concurrency 24.97”은 max-model-len 기준 최악값. 실제 수용량은 233개로 9배 넘게 차이 났다.
--enforce-eager로 CUDA 그래프를 끄면 KV 캐시가 47% 늘어난다.- 최신 Colab에서 이 실습을 하려면 Python 3.13 제약, torch/torchaudio CUDA 정합, torchvision 의존성,
vllm bench serve경로 변경을 모두 처리해야 한다.
참고
- 실습 Colab 노트북 (직접 실행한 결과) — 이 글의 3종 비교(FP16/W8A8/W4A16) 환경 구성부터 vLLM 서버 기동, concurrency별 벤치마크까지 직접 돌려서 나온 결과다. 위 숫자들을 그대로 재현해볼 수 있다.
- 실습 노트북: orca3/llm-model-inference
ch06/quantization_3way_300.ipynb - vLLM 양자화 문서
- 1주차: GPT를 200줄의 순수 Python으로
- 2주차: append 한 줄이 페타바이트가 되기까지